

Peu de concepts du marketing technologique moderne suscitent autant de discours enthousiastes et vagues que la « personnalisation par l'IA à grande échelle ».
Ouvrez la page d'accueil de n'importe quel éditeur de logiciels et vous y trouverez des promesses éblouissantes : des expériences web hyper-individualisées, des recommandations de produits en temps réel adaptées à l'état psychologique exact de l'utilisateur et des messages dynamiques qui s'ajustent à la seconde près. Cela ressemble à de la magie. Mais discutez avec les équipes d'ingénierie et de données chargées de construire ces systèmes, et vous entendrez une tout autre histoire : une réalité éprouvante faite de modèles fragiles, de factures cloud qui explosent et de pics de latence qui agacent les utilisateurs au lieu de les convertir.
L'écart entre le discours marketing et la réalité de la production ne résulte pas d'une défaillance des algorithmes d'apprentissage automatique. Il s'agit d'un échec architectural. La véritable personnalisation à grande échelle ne se résout pas en ajoutant un widget de chat générique ou un plugin de recommandation prêt à l'emploi sur le front-end d'un site web. Elle exige une architecture de données robuste et à faible latence, capable de transformer la télémétrie comportementale brute en décisions immédiates pilotées par des modèles.
1. L'illusion de la personnalisation statique
Pour comprendre pourquoi les moteurs de personnalisation traditionnels échouent à l'échelle de l'entreprise, il faut d'abord identifier ce qui n'allait pas dans les approches historiques.
Pendant des années, la « personnalisation » a signifié segmentation statique : une logique de branchement fondée sur des règles, construite à partir de catégories démographiques grossières ou d'étiquettes historiques rigides (par exemple : si l'utilisateur arrive depuis un appareil mobile et a cliqué sur une publicité de fitness, lui afficher la bannière d'entraînement). Bien que préférables à une page d'accueil générique, ces systèmes souffrent de sérieuses limites structurelles :
- La latence du traitement par lots : les systèmes traditionnels s'appuient sur des tâches ETL nocturnes par lots pour mettre à jour les profils utilisateurs. Si un client passe trente minutes à parcourir des vêtements de luxe sur votre site, un moteur fonctionnant par lots ne reflétera cette intention que le lendemain matin, bien après que l'utilisateur a quitté le site.
- L'explosion combinatoire : à mesure que l'on ajoute des variables (historique de navigation, valeur du panier, région géographique, heure de la journée, niveaux de stock), les moteurs de règles codées en dur croissent de manière exponentielle. Maintenir des milliers de règles « si/alors » qui se chevauchent devient rapidement un cauchemar d'ingénierie ingérable.
- Le manque de fluidité contextuelle : les segments statiques traitent les utilisateurs comme des personas monolithiques. Ils ne parviennent pas à saisir les micro-moments, comme le passage soudain d'une simple recherche à une intention d'achat urgente, faute de boucle de rétroaction comportementale en temps réel.
2. L'architecture moderne d'un pipeline de personnalisation
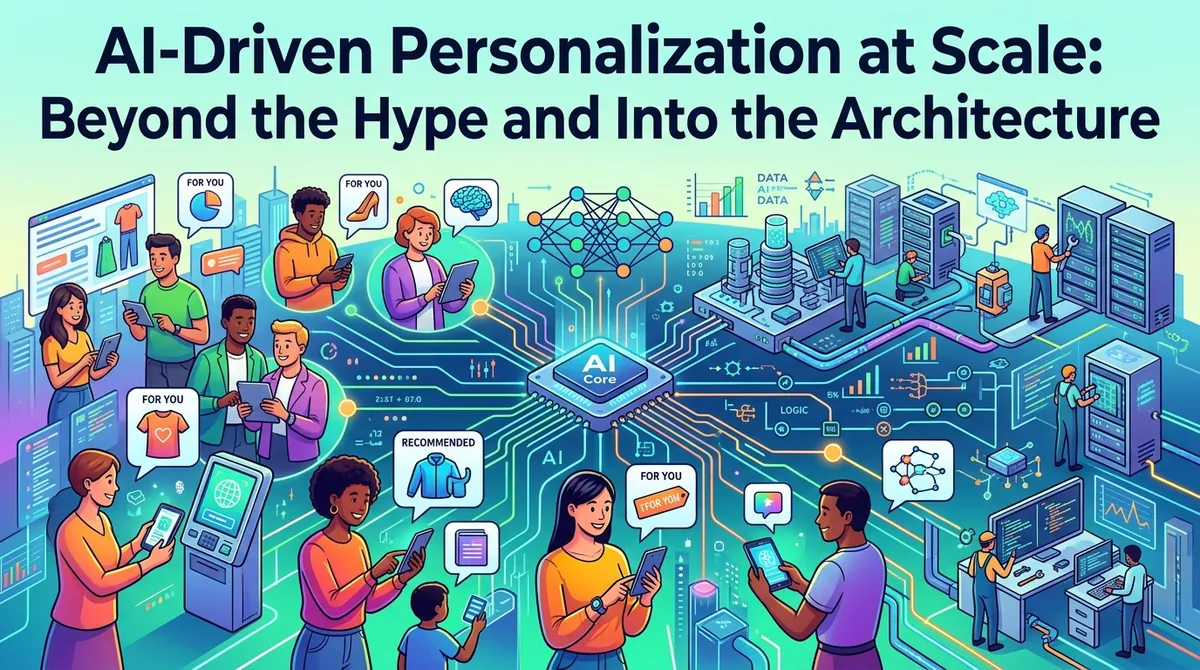
Passer de règles statiques à une véritable personnalisation par l'IA suppose de traiter l'engagement des utilisateurs comme un flux de données continu. Plutôt que d'interroger une base de données relationnelle surchargée à chaque chargement de page, les architectures à grande échelle reposent sur un pipeline découplé à quatre niveaux :
- 1Télémétrie du navigateur et de l'application : chaque clic, pause de défilement, survol et ajout au panier est capturé instantanément sous forme de données d'événement brutes.
- 2Le flux d'événements : les entreprises utilisent des courtiers d'événements distribués, comme Apache Kafka ou Apache Flink, pour ingérer des millions d'événements de télémétrie par seconde sans perte de données ni goulets d'étranglement côté serveur.
- 3Traitement de flux en temps réel et feature stores : les journaux bruts sont normalisés et transformés à la volée en variables exploitables par les modèles. Les feature stores (comme Feast) et les bases de données vectorielles stockent des embeddings de grande dimension pour la similarité sémantique et calculent les variables comportementales en moins de 50 millisecondes.
- 4Moteur d'inférence : lorsqu'un utilisateur demande une page, le moteur d'inférence évalue le vecteur de variables en temps réel, note les recommandations à l'aide d'un modèle d'apprentissage automatique et sert le contenu personnalisé dans une fenêtre stricte de moins de 100 millisecondes.
3. Concevoir pour la périphérie : trouver l'équilibre entre coût et latence
L'un des pièges les plus courants de la personnalisation en entreprise consiste à lancer des inférences coûteuses et centralisées de LLM ou d'apprentissage profond pour chaque ajustement mineur de l'interface. Généraliser cette approche mènera rapidement votre infrastructure cloud à la ruine.
Une architecture durable exige une stratégie de calcul à plusieurs niveaux :
- Mise en cache en périphérie et heuristiques : pour les utilisateurs anonymes ou les pages à faible intention, appuyez-vous sur des workers en périphérie (comme Cloudflare Workers ou les fonctions AWS CloudFront) pour servir instantanément des variantes mises en cache, sans aucune charge sur le serveur d'origine.
- Personnalisation approfondie asynchrone : réservez l'inférence lourde et la personnalisation par IA générative aux moments à forte intention, comme les parcours de paiement, les pages de tarifs ou les tableaux de bord des utilisateurs connectés, là où le retour sur investissement d'une individualisation précise justifie le coût de calcul.
- Dégradation progressive : si le modèle de personnalisation ou le feature store subit un pic de latence ou un délai d'expiration, le système doit immédiatement basculer vers une expérience par défaut robuste plutôt que d'afficher un écran vide ou une erreur 500 à l'utilisateur.
4. Rendre la personnalisation par l'IA opérationnelle : un plan d'action pour les équipes techniques
Si votre organisation prévoit de dépasser le discours marketing pour construire un moteur de personnalisation de niveau production, suivez cette feuille de route :
- 1Commencer par un cas d'usage clair : ne construisez pas une « plateforme de personnalisation par l'IA » généraliste. Résolvez d'abord un goulet d'étranglement précis et à fort impact, comme les recommandations de produits dynamiques dans les e-mails de relance de panier abandonné ou l'ajustement en temps réel de la mise en page des pages d'atterrissage à fort trafic.
- 2Unifier vos silos de données : les modèles d'IA ne valent que ce que valent les données qui les alimentent. Si vos données CRM, votre télémétrie web et vos bases de données transactionnelles vivent dans des silos isolés, votre moteur de personnalisation produira des expériences fragmentées et contradictoires.
- 3Surveiller la dérive des modèles et la latence : contrairement au code logiciel traditionnel, les modèles d'apprentissage automatique se dégradent avec le temps à mesure que le comportement des utilisateurs évolue. Mettez en place une observabilité MLOps rigoureuse pour suivre en continu la dérive des prédictions, la fraîcheur des variables et les goulets d'étranglement de latence.
Conclusion
La personnalisation par l'IA à grande échelle n'est pas une fonctionnalité logicielle prête à l'emploi que l'on peut acheter sur étagère ; c'est une discipline d'ingénierie.
Les organisations qui abordent la personnalisation comme un simple exercice de marketing front-end continueront de se heurter à des coûts cloud démesurés et à des gains de conversion décevants. À l'inverse, celles qui investissent dans des pipelines de flux d'événements propres, des feature stores à faible latence et des architectures d'inférence rigoureuses transformeront les données en temps réel en une expérience client profondément réactive et individualisée. Dans le paysage numérique actuel, la véritable intelligence ne tient pas à la quantité de données collectées, mais à la rapidité avec laquelle on transforme un événement en action.