

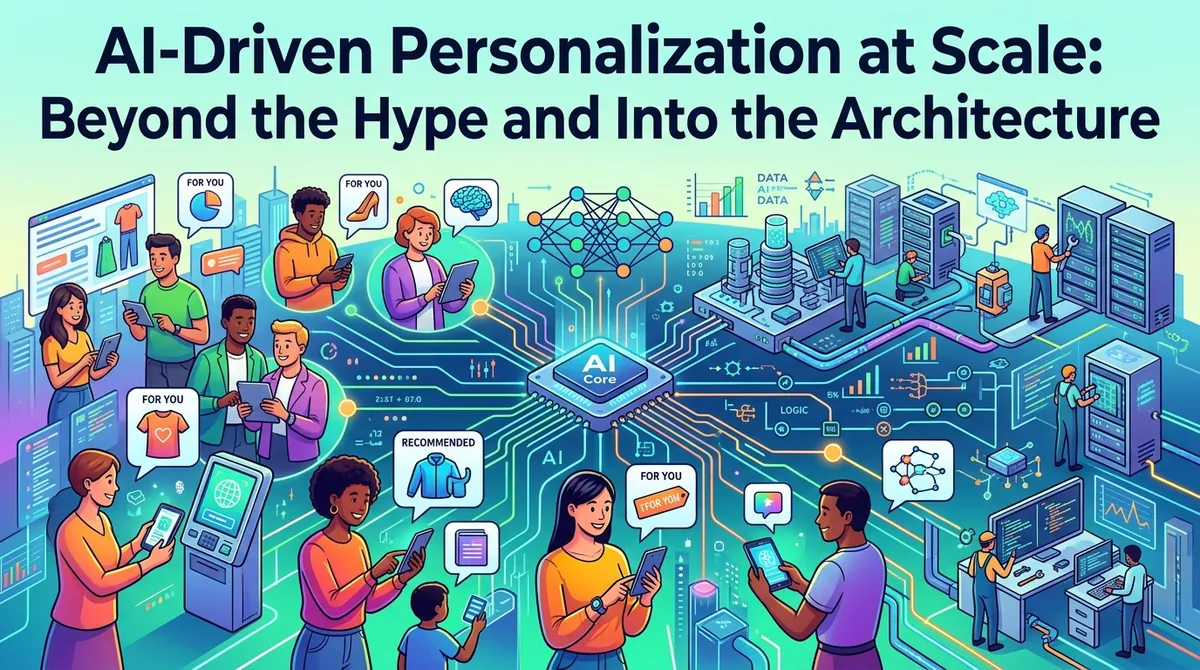
Pocos conceptos del marketing tecnológico actual generan tantas promesas entusiastas y vagas como la "personalización a escala impulsada por IA".
Basta con abrir la página de destino de cualquier proveedor de software para encontrar promesas deslumbrantes de experiencias web hiperindividualizadas, recomendaciones de productos en tiempo real adaptadas al estado psicológico exacto del usuario y mensajes dinámicos que se ajustan segundo a segundo. Suena a magia. Pero si se habla con los equipos de ingeniería y de datos encargados de construir estos sistemas, la historia es muy distinta: una realidad agotadora de modelos frágiles, facturas de la nube disparadas y picos de latencia que frustran a los usuarios en lugar de convertirlos.
La distancia entre el bombo del marketing y la realidad en producción no se debe a un fallo de los algoritmos de aprendizaje automático. Es un fallo de arquitectura. La verdadera personalización a escala no se resuelve añadiendo un widget de chat genérico o un complemento de recomendaciones estándar a la interfaz de un sitio web. Requiere una arquitectura de datos robusta y de baja latencia, capaz de convertir la telemetría de comportamiento en bruto en decisiones inmediatas basadas en modelos.
1. La falacia de la personalización estática
Para entender por qué los motores de personalización tradicionales se vienen abajo a escala empresarial, primero hay que identificar qué falló en los enfoques heredados.
Durante años, "personalización" significó segmentación estática: una lógica de ramificación basada en reglas y construida sobre grandes categorías demográficas o etiquetas históricas rígidas (por ejemplo, si el usuario accede desde un dispositivo móvil y ha hecho clic en un anuncio de fitness, mostrarle el banner de entrenamiento). Aunque son mejores que una página de inicio genérica, estos sistemas adolecen de graves limitaciones estructurales:
- La latencia del procesamiento por lotes: los sistemas tradicionales dependen de procesos ETL por lotes que se ejecutan cada noche para actualizar los perfiles de usuario. Si un cliente pasa treinta minutos explorando ropa de lujo en el sitio web, un motor basado en lotes no reflejará esa intención hasta la mañana siguiente, mucho después de que el usuario se haya marchado.
- Explosión combinatoria: a medida que se añaden más variables (historial de navegación, valor del carrito, región geográfica, hora del día, niveles de inventario), los motores de reglas codificadas crecen de forma exponencial. Mantener miles de reglas "si/entonces" que se solapan se convierte rápidamente en una pesadilla de ingeniería inabarcable.
- Falta de fluidez contextual: los segmentos estáticos tratan a los usuarios como perfiles monolíticos. No logran captar los micromomentos, como el paso repentino de una búsqueda informal a una intención de compra urgente, porque carecen de un circuito de retroalimentación del comportamiento en tiempo real.
2. La arquitectura moderna del pipeline de personalización
Pasar de las reglas estáticas a una verdadera personalización impulsada por IA exige tratar la interacción de los usuarios como un flujo de datos continuo en streaming. En lugar de consultar una base de datos relacional sobredimensionada en cada carga de página, las arquitecturas de gran escala se apoyan en un pipeline desacoplado de cuatro niveles:
- 1Telemetría del navegador y de la aplicación del usuario: cada clic, pausa en el desplazamiento, paso del cursor y producto añadido al carrito se captura al instante como datos de eventos en bruto.
- 2El flujo de eventos: las empresas utilizan intermediarios de eventos distribuidos, como Apache Kafka o Apache Flink, para ingerir millones de eventos de telemetría por segundo sin perder fotogramas ni crear cuellos de botella en los servidores.
- 3Procesamiento de flujos en tiempo real y feature stores: los registros en bruto se normalizan y se transforman sobre la marcha en variables listas para el modelo. Los feature stores (como Feast) y las bases de datos vectoriales almacenan embeddings de alta dimensión para la similitud semántica y calculan las variables de comportamiento en menos de 50 milisegundos.
- 4Motor de inferencia del modelo: cuando un usuario solicita una página, el motor de inferencia evalúa el vector de variables en tiempo real, puntúa las recomendaciones mediante un modelo de aprendizaje automático y sirve el recurso personalizado dentro de un margen estricto de menos de 100 milisegundos.
3. Diseñar para el edge: equilibrio entre coste y latencia
Uno de los errores más habituales en la personalización empresarial es ejecutar inferencias costosas y centralizadas de LLM o de aprendizaje profundo para cada ajuste menor de la interfaz. Escalar este enfoque puede arruinar rápidamente la infraestructura en la nube.
Una arquitectura sostenible requiere una estrategia de computación por niveles:
- Caché en el edge y heurísticas: para los usuarios anónimos o las páginas con baja intención, conviene recurrir a edge workers (como Cloudflare Workers o las funciones de AWS CloudFront) que sirvan variaciones almacenadas en caché al instante, sin ninguna carga para el servidor de origen.
- Personalización profunda asíncrona: la inferencia de modelos pesados y la personalización con IA generativa deben reservarse para los momentos de alta intención, como los flujos de pago, las páginas de precios o las experiencias de panel con sesión iniciada, en los que el ROI de una individualización precisa justifica el coste de computación.
- Degradación controlada: si el modelo de personalización o el feature store sufren un pico de latencia o un tiempo de espera agotado, el sistema debe recurrir al instante a una experiencia predeterminada robusta, en lugar de mostrar al usuario una pantalla en blanco o un error 500.
4. Poner en producción la personalización con IA: una guía para los equipos técnicos
Para las organizaciones que planean ir más allá del bombo del marketing y construir un motor de personalización apto para producción, esta es la hoja de ruta:
- 1Empezar con un caso de uso claro: no hay que construir una "plataforma de personalización con IA" generalista. Primero conviene resolver un cuello de botella concreto y de alto impacto, como las recomendaciones dinámicas de productos en los correos de recuperación de carritos o los ajustes de diseño en tiempo real para páginas de destino con mucho tráfico.
- 2Unificar los silos de datos: los modelos de IA son tan buenos como los datos que los alimentan. Si los datos del CRM, la telemetría web y las bases de datos transaccionales viven en silos aislados, el motor de personalización producirá experiencias fragmentadas y contradictorias.
- 3Supervisar la deriva de los modelos y la latencia: a diferencia del código de software tradicional, los modelos de aprendizaje automático se degradan con el tiempo a medida que cambia el comportamiento de los usuarios. Es necesario implantar una observabilidad de MLOps rigurosa para vigilar de forma continua la deriva de las predicciones, la actualidad de las variables y los cuellos de botella de latencia.
Conclusión
La personalización a escala impulsada por IA no es una funcionalidad de software lista para usar que pueda comprarse sin más; es una disciplina de ingeniería.
Las organizaciones que tratan la personalización como un ejercicio de marketing en la interfaz seguirán lidiando con costes de nube desorbitados y mejoras de conversión decepcionantes. Por el contrario, las que invierten en pipelines de streaming de eventos bien diseñados, feature stores de baja latencia y arquitecturas de inferencia disciplinadas convertirán los datos en tiempo real en una experiencia de cliente individualizada y con una gran capacidad de respuesta. En el panorama digital actual, la verdadera inteligencia no depende de cuántos datos se recopilan, sino de la rapidez con la que un evento se convierte en una acción.